Mostrando postagens com marcador Java. Mostrar todas as postagens

segunda-feira, 8 de julho de 2019

Estrutura de Dados - Ordenação Parte 1 - Bubble sort e Quick sort

Ordenação
Hoje em dia temos que lidar com um grande volume de informações e será mais fácil lidar com elas se estiverem ordenadas com base em algum critério.

Imagina uma agenda de contatos onde os nomes são colocados de maneira sequencial, sem nenhum critério de ordenação. Ao buscar um nome específico, será necessário percorrer essa lista inteira até encontrar. No melhor caso o será  o primeiro e o pior caso será o último. Esse processo pode ser demorado caso a quantidade de informações seja muito grande.

A escolha do algoritmo de ordenação ideal é deve levar em consideração uma  série de variáveis como volume de informação, estrutura de dados de armazenamento, etc.

Hoje vamos falar sobre ordenação por troca, isto é, os elementos serão comparados uns aos outros e trocados de acordo com o critério desejado.

Os dois algoritmos mais básicos desse tipo de ordenação são o Bubble Sort e o Quick Sort

Bubble Sort
O algoritmo mais simples e conhecido, de fácil compreensão e implementação. Neste algoritmo, cada elemento será comparado com seu sucessor e trocado caso esteja fora de ordem. Com isso podemos perceber que será necessário várias iterações até que os elementos estejam completamente ordenados.


Apesar de ser simples de implementar, esse algoritmo possui uma ordem de N AO QUADRADO. Isso significa que seu desempenho terá uma curva crescente em função da quantidade de elementos.


Esse algoritmo então, pode não ser a escolha ideal caso tenhamos muitos elementos para ordenar e sim em um conjunto finito e controlado.

public class BubbleSort {

 public static void ordenar(int[] arr) {
  int n = arr.length;
  int temp = 0;
  for (int i = 0; i < n; i++) {
   for (int j = 1; j < (n - i); j++) {
    if (arr[j - 1] > arr[j]) {
     temp = arr[j - 1];
     arr[j - 1] = arr[j];
     arr[j] = temp;
    }

   }
  }
 }

 public static void main(String[] args) {
  int arr[] = { 3, 60, 35, 2, 45, 320, 5 };

  System.out.println("Antes de ordenar");
  imprimir(arr);
  System.out.println();

  ordenar(arr);

  System.out.println("Depois de ordenar");
  imprimir(arr);
 }

 private static void imprimir(int[] arr) {
  for (int i = 0; i < arr.length; i++) {
   System.out.print(arr[i] + " ");
  }
 }

}


Quick Sort
Este algoritmos usa a estratégia "Dividir para conquistar". O primeiro passo é escolher um pivô, em seguida, todos os elementos a direita que forem "menores" serão passados para esquerda do pivô e os elementos da esquerda que forme "maiores" serão passados para direita do pivô. No final dessa iteração, o pivô estará exatamente na posição que deveria.
O próximo passo é repetir esse passo para as sublistas a direita e à esquerda do pivô.


public class QuickSort {
 
 public static void ordenar(int arr[], int inicio, int fim) {
  if (inicio < fim) {
         int particao = particionar(arr, inicio, fim);
  
         ordenar(arr, inicio, particao-1);
         ordenar(arr, particao+1, fim);
     }
 }
 
 private static int particionar(int arr[], int inicio, int fim) {
     int pivo = arr[fim];
     int i = (inicio-1);
  
     for (int j = inicio; j < fim; j++) {
         if (arr[j] <= pivo) {
             i++;
  
             int temp = arr[i];
             arr[i] = arr[j];
             arr[j] = temp;
         }
     }
  
     int temp = arr[i+1];
     arr[i+1] = arr[fim];
     arr[fim] = temp;
  
     return i+1;
 }

 
 public static void main(String[] args) {
  int arr[] = { 3, 60, 35, 2, 45, 320, 5 };

  System.out.println("Antes de ordenar");
  imprimir(arr);
  System.out.println();

  ordenar(arr,0,arr.length-1);

  System.out.println("Depois de ordenar");
  imprimir(arr);
 }

 private static void imprimir(int[] arr) {
  for (int i = 0; i < arr.length; i++) {
   System.out.print(arr[i] + " ");
  }
 }

}

domingo, 16 de junho de 2019

Estrutura de Dados Parte 5 - Tabela de Espalhamento

Tabela de espalhamento

A tabela de espalhamento ou tabela de hash é uma estrutura que consiste em indexar os elementos armazenados de maneira que seja fácil e rápido encontrar qualquer elemento a partir de sua chave.
Essa estrutura não tem a premissa de armazenar os elementos de maneira sequencial e sim de identificar uma categoria para o elemento e armazená-lo de acordo.

É uma estrutura muito usada tanto na computação quanto no dia a dia.

  1. Agenda telefônica
  2. Corredores de supermercado
  3. Organizar livros em uma biblioteca

O primeiro passo é identificar a qual categoria pertence o elemento que queremos armazenar, para isso temos a "função hash". Esta função é responsável por gerar o índice do elemento. Portanto, essa função deve ser escolhida com cuidado pois caso a função seja mal implementada a tabela terá uma performance ruim.

Vamos pegar um exemplo de uma agenda telefônica.

Para armazenar o nome "Geraldo", executamos a função hash que irá produzir o índice "G".
Já o nome "Nayara" irá produzir o índice "N" e o nome "Fábio" irá produzir o índice "F".

Desta maneira sabemos que os elementos serão armazenados da seguinte maneira:


Para recuperar o nome "Fábio" usamos novamente o índice "F" e acessamos o elemento diretamente.

Mesmo que a nossa "função hash" seja muito boa, ainda assim estamos sujeitos a colisões, que é quando dois elementos distintos produzem o mesmo índice. O nome "Francisco" também produz o índice "F" e no exemplo acima ocorreria uma colisão com o nome "Fábio".

Nesse caso precisamos combinar mais de uma estrutura para permitir que os dois elementos possam coexistir.


Podemos combinar as estruturas "tabela de espalhamento" e alguma outra estrutura que melhor encaixe no nosso contexto como Pilhas, Filas e Listas, etc.

public class TabelaEspalhamentoApp {
 
 public static void main(String[] args) {
  TabelaEspalhamento tabela = new TabelaEspalhamento();

  tabela.adiciona("Nayara");
  tabela.adiciona("Geraldo");
  tabela.adiciona("Gorge");
  tabela.adiciona("Fabio");

  System.out.println(tabela.contem("Geraldo"));

  tabela.remove("Gorge");
  System.out.println(tabela.contem("Geraldo"));
  System.out.println(tabela.contem("Gorge"));

 }

}

public class TabelaEspalhamento {

 VetorGenerico vetor = new VetorGenerico();

 public void remove(String elemento) {
  int indice = recuperarIndice(elemento);
  Vetor v = (Vetor) vetor.get(indice);
  if (v != null) {
   int posicao = v.indice(elemento);
   if (posicao >= 0) {
    v.remove(posicao);
   }

  }
 }

 public boolean contem(String elemento) {
  int indice = recuperarIndice(elemento);
  Vetor v = (Vetor) vetor.get(indice);
  if (v != null) {
   return v.has(elemento);
  }
  return false;
 }

 public void adiciona(String elemento) {
  int indice = recuperarIndice(elemento);
  Vetor v = (Vetor) vetor.get(indice);
  if (v == null) {
   v = new Vetor();
  }
  v.add(elemento);
  vetor.add(indice, v);
 }

 private int recuperarIndice(String elemento) {
  return elemento.charAt(0) % 75;
 }

}

public class VetorGenerico{

 Object[] elementos = new Object[1000];
 int indice;

 public void add(Object elemento) {
  elementos[indice] = elemento;
  indice++;
 }

 public Object get(int i) {
  return elementos[i];
 }

 public void add(int posicao, Object elemento) {
  for (int i = indice - 1; i >= posicao; i--) {
   elementos[i + 1] = elementos[i];
  }

  elementos[posicao] = elemento;
  indice++;
 }
 
 public void remove(int posicao) {
  elementos[posicao] = null;

  for (int i = posicao; i + 1 < elementos.length; i++) {
   elementos[i] = elementos[i + 1];
  }

  indice--;
 }
}

Estrutura de Dados - Pesquisa - Sequencial ou Linear, Binária e Interpolação

PESQUISA

Nos dias de hoje, o acesso rápido a informação pode ser determinante para o sucesso do aplicativo. Por isso o algoritmo de pesquisa é tão importante quanto a estrutura de armazenamento e o algoritmo de ordenação.


PESQUISA SEQUENCIAL

Vamos falar do mecanismo de pesquisa mais trivial que existe, a Pesquisa Linear ou Sequencial.

Esse algoritmo consiste em percorrer cada um dos elementos da nossa estrutura até encontrar o elemento desejado. Sua eficiência é inversamente proporcional a quantidade de elementos que tivermos que percorrer. Na melhor hipótese o elemento desejado será o primeiro e na pior hipótese o elemento desejado será o último.

Podemos melhorar significativamente o desempenho se os elementos estiverem ordenados. Por isso é tão importante escolher a estrutura certa assim como aplicar algoritmos de ordenação.

Por exemplo, se queremos encontrar um nome específico na nossa agenda telefônica, será muito mais rápido se a agenda estiver organizada por ordem alfabética. Assim podemos pular alguns nome que temos certeza que não irão atender ao critério de pesquisa.

public class PesquisaLinear {

 public static int pesquisar(String arr[], String argumento) {
  
  for (int i = 0; i < arr.length; i++) {
   if (arr[i] == argumento) {
    return i;
   }
  }

  return -1;
 }

 public static void main(String args[]) {
  String arr[] = { "A", "B", "C", "D" };
  System.out.println(pesquisar(arr, "C"));
 }

}


PESQUISA BINÁRIA

A pesquisa binária utiliza da técnica "dividir para conquisar". Consiste em dividir os elementos ao meio, em seguida é verificado se o elemento desejado é maior ou menor que o elemento central. Caso seja maior, então o elemento desejado obrigatoriamente deve estar do lado direito da divisão e caso seja menor então obrigatoriamente deve estar do lado esquerdo. Esse processo de divisão e verificação é repetido até encontrar o elemento.
Repare para que esse algoritmo funcione, os elementos devem estar obrigatoriamente ordenados, caso contrário pode não funcionar.


public class PesquisaBinaria {

 public static int pesquisar(int arr[], int l, int r, int x) {
  if (r >= l) {
   int mid = l + (r - l) / 2;

   if (arr[mid] == x)
    return mid;

   if (arr[mid] > x)
    return pesquisar(arr, l, mid - 1, x);

   return pesquisar(arr, mid + 1, r, x);
  }

  return -1;
 }

 public static void main(String args[]) {
  int arr[] = { 2, 3, 4, 10, 40 };
  int n = arr.length;
  int x = 10;
  int posicao = pesquisar(arr, 0, n - 1, x);
  if (posicao == -1)
   System.out.println("Elemento não encontrado");
  else
   System.out.println("Elemento encontrado na posição " + posicao);
 }
}


PESQUISA POR INTERPOLAÇÃO

Este algoritmo de pesquisa, assim como a busca binária, tem como premissa que os elementos esteja previamente ordenados, além disso o algoritmo é semelhante a busca binária, eles diferem na forma como os elementos são divididos. Enquanto a busca binária está sempre dividindo ao meio, a busca por interpolação divide os elementos com base na fórmula abaixo:

pos = lo + [ (x-arr[lo])*(hi-lo) / (arr[hi]-arr[Lo]) ]

public class PesquisaInterpolacao {

 public static int pesquisar(int[] arr, int x) {
  int lo = 0, hi = (arr.length - 1);

  while (lo <= hi && x >= arr[lo] && x <= arr[hi]) {

   if (lo == hi) {
    if (arr[lo] == x)
     return lo;
    return -1;
   }

   int pos = lo + (((hi - lo) / (arr[hi] - arr[lo])) * (x - arr[lo]));

   if (arr[pos] == x)
    return pos;

   if (arr[pos] < x)
    lo = pos + 1;

   else
    hi = pos - 1;
  }
  return -1;
 }

 public static void main(String[] args) {
  int x = 18;
  int arr[] = new int[] { 10, 12, 13, 16, 18, 19, 20, 21, 22, 23, 24, 33, 35, 42, 47 };
  int posicao = pesquisar(arr, x);

  if (posicao != -1)
   System.out.println("Elemento encontrado na posição " + posicao);
  else
   System.out.println("Elemento não encontrado.");
 }

}

Estrutura de Dados - Ordenação Parte 2 - Selection, Insertion e Shell sort

Selection sort.

O algoritmo consiste em selecionar o menor (ou maior) elemento fora de ordem colocá-lo em sua posição correta. Para fazer isso, primeiro os elementos devem ser divididos em duas partes: os elementos já ordenados e os elementos que ainda não foram ordenados.

Inicialmente a parte ordenada estará vazia, enquanto a parte não ordenada possuirá todos os elementos.

Após a divisão, o algoritmo irá encontrar o menor elemento do lado não ordenado e colocá-lo no lado ordenado. Esse passo irá se repetir até que o lado não ordenado fique vazio.

Este algoritmo possui duas grandes vantagens, primeiro, é um algoritmo simples de ser implementado e segundo, não há consumo de memória além daquele já alocado para os elementos originais, uma vez que a divisão de lado ordenado e lado não ordenado é feita no próprio vetor que queremos ordenar.

A maior desvantagem é que é um algoritmo que não tem um bom desempenho quando temos uma quantidade de elementos muito grande.


public class SelectionSort {

 public static void ordenar(int arr[]) {
  int n = arr.length;

  for (int i = 0; i < n - 1; i++) {
   int min = i;
   for (int j = i + 1; j < n; j++)
    if (arr[j] < arr[min])
     min = j;

   int temp = arr[min];
   arr[min] = arr[i];
   arr[i] = temp;
  }
 }

 public static void main(String args[]) {
  int arr[] = { 64, 25, 12, 22, 11 };

  System.out.println("Antes de ordenar");
  imprimir(arr);

  ordenar(arr);

  System.out.println("Depois de ordenar");
  imprimir(arr);
 }

 public static void imprimir(int arr[]) {
  int n = arr.length;
  for (int i = 0; i < n; ++i)
   System.out.print(arr[i] + " ");
  System.out.println();
 }

}


Insertion sort

O algoritmos consiste inicialmente em selecionar um pivô e comparar os elementos seguintes, um a um. Se o elemento seguinte for maior que o pivô, esse elemento agora passará a ser o novo pivô. Se o elemento for menor que o pivô, os elementos anteriores ao pivô serão percorridos até ser encontrado o elemento maior que o elemento encontrado anteriormente colocando-o logo antes do elemento maior.

Este algoritmo possui uma vantagem: não há consumo de memória além daquele já alocado para os elementos originais, uma que toda a ordenação ocorre dentro dos próprios elementos.

A maior desvantagem é que é um algoritmo que não tem um bom desempenho quando temos uma quantidade de elementos muito grande, assim como o selection sort.


public class InsertionSort {

 public static void sort(int arr[]) {
  int n = arr.length;
  for (int i = 1; i < n; ++i) {
   int k = arr[i];
   int j = i - 1;

   while (j >= 0 && arr[j] > k) {
    arr[j + 1] = arr[j];
    j = j - 1;
   }
   arr[j + 1] = k;
  }
 }

 public static void main(String args[]) {
  int arr[] = { 12, 11, 13, 5, 6 };
  
  System.out.println("Antes de ordenar");
  imprimir(arr);

  sort(arr);

  System.out.println("Depois de ordenar");
  imprimir(arr);
 }

 public static void imprimir(int arr[]) {
  int n = arr.length;
  for (int i = 0; i < n; ++i)
   System.out.print(arr[i] + " ");

  System.out.println();
 }

}


Shell sort

Este algoritmo consiste em realizar trocas entre os elementos que estão posicionados a uma distância determinada. A distância inicial pode ser definida por d = n /  2 e a cada iteração diminuímos a essa distância, por exemplo, se você tem 10 elementos

iteração 1) d = 10 / 2 = 5;
iteração 2) d =  5 / 2 = 3;
iteração 3) d =  3 / 2 = 2
iteração 4) d =  2 / 2 = 1

Os elementos estarão ordenados quando a distância for menor ou igual a zero.


public class ShellSort {

 public static int ordenar(int arr[]) {
  int n = arr.length;

  for (int gap = n / 2; gap > 0; gap /= 2) {
   for (int i = gap; i < n; i += 1) {
    int temp = arr[i];

    int j;
    for (j = i; j >= gap && arr[j - gap] > temp; j -= gap)
     arr[j] = arr[j - gap];

    arr[j] = temp;
   }
  }
  return 0;
 }

 public static void main(String args[]) {
  int arr[] = { 12, 34, 54, 2, 3 };
  
  System.out.println("Antes de ordenar");
  imprimir(arr);

  ordenar(arr);

  System.out.println("Depois de ordenar");
  imprimir(arr);
 }

 public static void imprimir(int arr[]) {
  int n = arr.length;
  for (int i = 0; i < n; ++i)
   System.out.print(arr[i] + " ");
  System.out.println();
 }
}

sábado, 25 de maio de 2019

Estrutura de Dados Parte 4 - Árvore

Árvores


Árvores são estruturas hierárquicas que permitem fazer associações entre elementos chamados de nós. Esses elementos podem ser pais ou/ou filhos, isso significa que, diferente das listas, os nós não estão dispostos de maneira linear e sim acima ou abaixo uns dos outros. Sempre que um nó possuir filhos teremos uma sub-árvore.

Para entender melhor essa estrutura precisamos primeiro conhecer algumas partes de uma árvore:

Nó raiz: é o primeiro nó da estrutura, é a partir dele que os outros nós irão existir.
Nós filhos: são nós que pertencem ao nó raiz ou a qualquer outro nó.
Grau: o grau de um nó é determinado pela quantidade de filhos que ele possui.
Nível: o nó raiz é considerado o nível zero, a partir dele, cada geração é considerada mais um nível.
Nós folhas: são nós que não possuem filhos.
Profundidade: é o maior nível de uma árvore.

Para serem consideradas árvores essas estruturas podem ter apenas um nó raiz e
os nós podem ter apenas um nó pai.

As árvores podem ser usadas para representar diversas situações:

  1. Estrutura de pastas
  2. Árvore genealógica
  3. Organograma de uma empresa


Os tipos de árvores são:

  1. Árvores binárias
  2. Árvores B
  3. Árvores 2-3
Existem outros tipos de árvores mais complexas que não iremos tratar aqui.

Árvores Binárias

São árvores onde os nós obrigatoriamente possuem 0, 1 ou 2 filhos. Os filhos são posicionados sempre na esquerda ou na direita de acordo com o critério de grandeza adotado.


Árvore B

São árvores que possuem uma ordem de grandeza M que define a quantidade de elementos chave que um nó irá possuir.
O nó raiz deverá possuir no mínimo 2 elementos chaves.
Cada nó deverá possuir no máximo M-1 e no mínimo M/2 elementos chave.

Por exemplo, uma árvore B com ordem de grandeza M=5, teria em seu nó raiz no mínimo dois elementos.Cada um desses elementos teria em seu nó filho no máximo 4 e no mínimo 2 elementos, cada elemento possuiria por sua vez um nó filho que seguiria o mesmo raciocínio.


Árvores 2-3

São árvores que permitem mais de um elemento (chave) em um único nó. Nessa estrutura,
se o nó possuir uma única chave, poderá possuir de 0 a 2 nós filhos. Agora se o nó possuir duas chaves, poderá ter de 0 a 3 nós filhos.
Podemos dizer que árvores 2-3 são árvores B com ordem de grandeza M=4


public class Arvore{
 
 public static void main(String[] args) {
  No raiz = new No("Raiz");
  
  No no1 = new No("No 1");
  No no11 = new No("No 1.1");
  No no12 = new No("No 1.2");
  
  no1.add(no11, 1);
  no1.add(no12, 2);
  
  No no2 = new No("No 2");
  No no21 = new No("No 2.1");
  no2.add(no21, 1);
  
  
  No no3 = new No("No 3");
  No no31 = new No("No 3.1");
  No no32 = new No("No 3.2");
  No no33 = new No("No 3.3");
  
  No no331 = new No("No 3.3.1");
  
  no33.add(no331, 1);
  
  no3.add(no31, 1);
  no3.add(no32, 2);
  no3.add(no33, 3);
  
  raiz.add(no1, 1);
  raiz.add(no2, 2);
  raiz.add(no3, 3);
  
  raiz.imprimir();
  
  
  System.out.println("--------");
  
  raiz.remover(2);
  raiz.imprimir();
  
  System.out.println("--------");
  
  no3.imprimir();
 }

}
public class No {

 private No[] filhos = new No[10];
 private String descricao;

 public No(String descricao) {
  this.descricao = descricao;
 }

 public void add(No no, int posicao) {
  filhos[posicao] = no;
 }

 public No[] getFilhos() {
  return filhos;
 }

 public String getDescricao() {
  return descricao;
 }

 public void imprimir() {
  imprimir(0);
 }

 public void remover(int i) {
  filhos[i] = null;
 }


 private void imprimir(int i) {
  System.out.println(tab(i)+descricao);
  i++;
  for (No no : filhos) {
   if (no != null) {
    no.imprimir(i);
   }
  }
  
 }

 private String tab(int i) {
  String retorno = "";
  for (int j = 0; j < i; j++) {
   retorno +="  ";
  }
  return retorno;
 }

}

terça-feira, 7 de maio de 2019

Estrutura de Dados Parte 3 - Lista

Quem diria, não levou 8 anos mas sim 8 dias para continuar a série =D.

A definição de Lista é muito simples: elas mantêm a ordem de inserção e permitem a repetição dos elementos. As operações básicas são:

ADD(x): operação para adicionar um elemento no final da lista.
ADD(i,x): operação para adicionar um elemento em uma posição específica.
GET(i): operação para recuperar um elemento em uma posição específica.
REMOVE(i): operação para remover um elemento em uma posição específica.

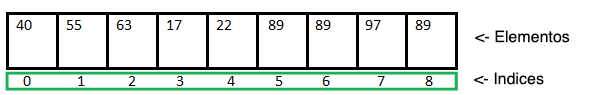
O tipo de lista mais simples é o Vetor. Sua implementação é baseada em uma estrutura sequencial, onde por padrão os elementos são adicionados no final, após o último elemento. Seu acesso é através da posição (índice) em que foram inseridos.


Essa implementação é excelente para acessar rapidamente um elemento, por exemplo, para acessar o elemento 63, basta informar o índice 2 e o acesso será direto (GET(2))

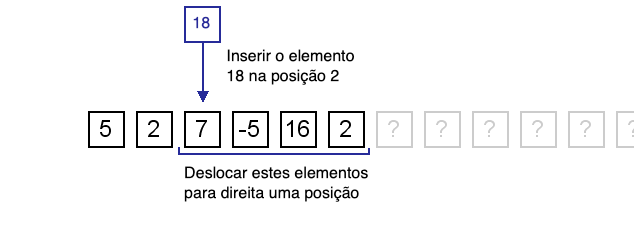
Porém não é tão interessante quando queremos inserir um elemento em uma posição no meio, por exemplo, na posição 3 (ADD(2, 18)) pois teríamos que deslocar todos os demais elementos para direita.


Apesar esse deslocamento ser uma operação simples, em um vetor com muitos elementos essa operação pode ser custosa e demorada.


public class Vetor implements Lista {

 String[] elementos = new String[10];
 int indice;

 @Override
 public void add(String elemento) {
  elementos[indice] = elemento;
  indice++;
 }
 
 @Override
 public String get(int i) {
  return elementos[i];
 }

 @Override
 public void add(int posicao, String elemento) {
  for (int i = indice - 1; i >= posicao; i--) {
   elementos[i + 1] = elementos[i];
  }

  elementos[posicao] = elemento;
  indice++;
 }
 
 @Override
 public void remove(int posicao) {
  elementos[posicao] = null;
  
  for (int i = posicao; i+1 < elementos.length; i++) {
   elementos[i] = elementos[i+1];
  }

  indice--;
 }
 
 public static void main(String[] args) {
  Vetor vetor = new Vetor();
  vetor.add("A");
  vetor.add("C");
  vetor.add("D");
  vetor.add("E");
  
  System.out.println(Arrays.asList(vetor.elementos));

  vetor.add(1, "B");

  String c = vetor.get(2);
  System.out.println(c);
  
  System.out.println(Arrays.asList(vetor.elementos));

  vetor.remove(2);
  
  System.out.println(Arrays.asList(vetor.elementos));
 }

}

Eis que surgem as Listas ligadas para o resgate =D.
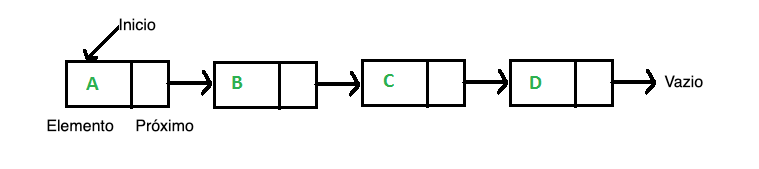
Essas listas possuem uma implementação mais elaborada. Para percorrer os elementos é necessário que cada elemento saiba onde está seu sucessor.


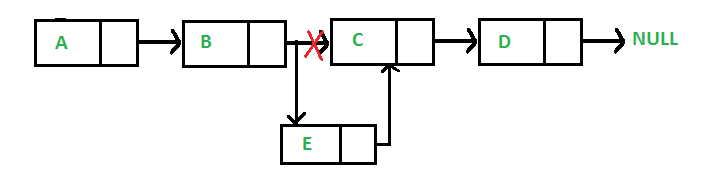
A grande vantagem desta implementação é que se precisarmos inserir um elemento no meio (ADD(2,'E')), basta fazer com que o elemento anterior aponte para o novo e o novo para o sucessor tornando a inserção uma operação rápida.


Em contrapartida, como nem tudo são flores, o acesso a um determinado elemento pelo índice já não é mais tão fácil. Na verdade, precisamos navegar do primeiro elemento perguntando onde está o próximo até chegarmos na posição desejada.
Além disso a navegação ocorre apenas em uma direção, do primeiro elemento até o último e há casos em que gostaríamos de ir e voltar nessa navegação.
public class ListaLigada implements Lista {

 No primeiro;
 No ultimo;

 @Override
 public void add(String elemento) {

  if (primeiro == null) {
   primeiro = new No(elemento);
   ultimo = primeiro;
  } else {
   ultimo.proximo = new No(elemento);
   ultimo = ultimo.proximo;
  }

 }

 @Override
 public String get(int posicao) {
  No no = buscarNo(posicao);
  return no.elemento;
 }

  @Override
 public void add(int posicao, String elemento) {
  No retorno = buscarNo(posicao-1);
  No novo = new No(elemento);
  novo.proximo=retorno.proximo;
  retorno.proximo = novo;
 }

 @Override
 public void remove(int posicao) {
  No retorno = buscarNo(posicao-1);
  No temp = retorno.proximo;
  retorno.proximo = temp.proximo;
 }
 
 private No buscarNo(int posicao) {
  No retorno = primeiro;
  int contador = 0;
  while (contador < posicao) {
   retorno = retorno.proximo;
   contador++;
  }
  return retorno;
 }
 
 public void imprimir() {
  String conteudo = primeiro.elemento;
  No proximoNo = primeiro.proximo;
  while(proximoNo != null) {
   conteudo+=", "+proximoNo.elemento;
   proximoNo = proximoNo.proximo;
  }
  System.out.println(conteudo);
 }

 public static void main(String[] args) {
  ListaLigada listaLigada = new ListaLigada();
  listaLigada.add("A");
  listaLigada.add("C");
  listaLigada.add("D");
  listaLigada.add("E");
  
  listaLigada.imprimir();

  listaLigada.add(1, "B");
  
  listaLigada.imprimir();

  String c = listaLigada.get(2);
  System.out.println(c);

  listaLigada.remove(2);
  
  listaLigada.imprimir();


 }

}

Para ter uma navegação bidirecional, a listas podem ser duplamente ligadas. Isso significa que o elemento sabe não só a posição do próximo mas também do anterior a ele, seu antecessor.


public class ListaDuplamenteLigada implements Lista {

 No primeiro;
 No ultimo;

 @Override
 public void add(String elemento) {
  addFim(elemento);
 }

 public void addFim(String elemento) {

  if (primeiro == null) {
   primeiro = new No(elemento);
   ultimo = primeiro;
  } else {
   No novo = new No(elemento);
   ultimo.proximo = novo;
   novo.anterior = ultimo;
   ultimo = novo;
  }
 }

 public void addInicio(String elemento) {
  if (primeiro == null) {
   primeiro = new No(elemento);
   ultimo = primeiro;
  } else {
   No novo = new No(elemento);
   
   primeiro.anterior = novo;
   novo.proximo = primeiro;
   primeiro = novo;
  }
 }

 @Override
 public String get(int posicao) {
  No no = buscarNo(posicao);
  return no.elemento;
 }

 @Override
 public void add(int posicao, String elemento) {
  No novo = new No(elemento);
  
  No esquerda = buscarNo(posicao - 1);  
  No direita = esquerda.proximo;
  
  novo.proximo = direita;
  novo.anterior = esquerda;
  
  direita.anterior = novo;
  esquerda.proximo = novo;
  
 }

 @Override
 public void remove(int posicao) {
  No retorno = buscarNo(posicao);
  
  No esquerda = retorno.anterior;
  No direita = retorno.proximo;
  
  esquerda.proximo = direita;
  direita.anterior = esquerda;
 }

 private No buscarNo(int posicao) {
  No retorno = primeiro;
  int contador = 0;
  while (contador < posicao) {
   retorno = retorno.proximo;
   contador++;
  }
  return retorno;
 }

 public void imprimirParaFrente() {
  String conteudo = primeiro.elemento;
  No proximoNo = primeiro.proximo;
  while (proximoNo != null) {
   conteudo += ", " + proximoNo.elemento;
   proximoNo = proximoNo.proximo;
  }
  System.out.println(conteudo);
 }
 
 public void imprimirParaTras() {
  String conteudo = ultimo.elemento;
  No noAnterior = ultimo.anterior;
  while (noAnterior != null) {
   conteudo += ", " + noAnterior.elemento;
   noAnterior = noAnterior.anterior;
  }
  System.out.println(conteudo);
 }

 public static void main(String[] args) {
  ListaDuplamenteLigada listaLigada = new ListaDuplamenteLigada();
  listaLigada.add("C");
  listaLigada.add("D");
  listaLigada.add("E");
  
  listaLigada.imprimirParaTras();
  listaLigada.imprimirParaFrente();
  System.out.println();
  listaLigada.addInicio("A");

  listaLigada.imprimirParaTras();
  listaLigada.imprimirParaFrente();
  System.out.println();

  listaLigada.add(1, "B");

  listaLigada.imprimirParaTras();
  listaLigada.imprimirParaFrente();
  System.out.println();

  String c = listaLigada.get(2);
  System.out.println(c);

  listaLigada.remove(2);

  listaLigada.imprimirParaTras();
  listaLigada.imprimirParaFrente();
  System.out.println();

 }

}

Resumindo:
- Listas são estruturas que permitem armazenar elementos garantindo sua ordem de inserção e permitindo repetir elementos.
- Vetor tem acesso rápido e fácil aos elementos porém pode demorar mais para inserir em determinadas posições.
- Listas ligadas e duplamente ligadas são excelentes para inserção em posições desejadas porém não são boas para acessar elementos específicos.

A sua escolha em relação à qual usar vai depender da sua necessidade. Acesso ou Inserção.

Podemos concluir também que as Pilhas e Listas são um tipo de lista que possuem características mais específicas.

quarta-feira, 1 de maio de 2019

Estrutura de Dados Parte 2 - Fila

Continuando a sequência de post's sobre estrutura de dados (8 anos depois =D)

Sempre gosto de começar o post com algum exemplo, e tento aproximá-lo ao máximo de situações que acontece em nosso dia-a-dia. Acredito que associar a algo prático ou a algo da nossa rotina torna mais fácil a compreensão do assunto, e tem algo mais comum que Filas no nosso dia-a-dia? Se vamos ao banco tem fila, se vamos ao supermercado tem fila, se vamos ao cinema na estreia dos Vingadores... tem fila. Apesar delas serem uma parte relativamente irritante da nossa vida, as filas são uma ótima forma de armazenar informações que pretendemos usar depois.

Quando temos que enfrentar filas no nosso dia a dia, procuramos sempre pela menor pois sabemos que quanto menor, mais rápido chegará nossa vez. Em outras palavras, por manterem a ordem, sabemos que quem chega primeiro é atendido primeiro.

Nas filas, ao contrários das Pilhas, o primeiro elemento a entrar é sempre o primeiro elemento a sair. Essa característica é conhecida como FIFO (First In, First Out) e possui apenas duas operações básicas chamadas de INSERT e REMOVE.


INSERT: operação para inserir um elemento no final da fila.
REMOVE: operação para remover um elemento do início da fila.

Outros operações que podem ser úteis:

isFull: operação que indica se a fila está cheia.
isEmpty: operação que indica se a fila está vazia.
size: operação que indica o tamanho da fila.

Uma implementação simples em java seria:

public class Fila {

 int tamanho = 10;
 String[] elementos = new String[tamanho];
 int fim = 0;
 int inicio = 0;

 public void insert(String elemento) {
  elementos[fim] = elemento;

  if (elemento != null && fim < tamanho) {
   fim++;
  }
 }

 public String remove() {
  String elemento = elementos[inicio];

  if (elemento != null) {
   inicio++;
  }
  return elemento;
 }

 public boolean isEmpty() {
  return inicio == fim;
 }

 public boolean isFull() {
  return size() == tamanho;
 }

 public int size() {
  return fim - inicio;
 }
 
 public static void main(String[] args) {
  Fila fila = new Fila();
  fila.insert("1");
  fila.insert("2");
  fila.insert("3");
  
  String e1 = fila.remove();
  System.out.println(e1);
  
  String e2 = fila.remove();
  System.out.println(e2);
  
  String e3 = fila.remove();
  System.out.println(e3);
 }

}


Reparem que ao executar o código, a saída será 1 2 3, nessa ordem, justamente por que o 1 foi o primeiro elemento inserido e será o primeiro a ser removido.

O que acontece se atingirmos a capacidade máxima da nossa fila? como seria possível continuar adicionando elementos? o que ocorre se removemos todos os elementos da lista? será que conseguimos continuar usando?

Há muitas melhorias que podem ser feitas nesta implementação para resolver as questões acima, mas isso deixaria a explicação bem mais complexa. Quem sabe não faço um post avançado sobre o assunto…

Uma coisa importante para ressaltar é que a maioria das linguagens de programação possuem uma biblioteca rica em estrutura de dados e que na maioria das vezes são suficientes para resolver 90% dos problemas. Nesses casos é preferível utilizar essas implementações pois já são otimizadas e testadas.

Filas são amplamente utilizadas na programação para resolver problemas que requerem uma ordem de execução como por exemplo a fila de arquivos para impressão ou o buffer de um vídeo no youtube.

Torcendo para que não leve mais 8 anos, esperem pelo próximo post sobre Listas.


quarta-feira, 7 de maio de 2014

Jeito certo de comparar Integers em Java

class A {
 public static void main(String[] args){
     Integer a1 = 125;
     Integer b1 = 125;
     System.out.println(a1==b1); //true
 }
}

class B {
 public static void main(String[] args){
  Integer a2 = 280;
  Integer b2 = 280;
  System.out.println(a2==b2);//false
 }
}

class C {
 public static void main(String[] args){
  Integer a3 = 280;
  System.out.println(a3==280);//true
 }
}


Quem já estudou para certificação está acostumado com esse tipo de pegadinha. Para entender esse comportamento vamos analisar o bytecode da classe A e B:

class A extends java.lang.Object{
A();
  Code:
   0: aload_0
   1: invokespecial #1; //Method java/lang/Object."<init>":()V
   4: return

public static void main(java.lang.String[]);
  Code:
   0: bipush 125
   2: invokestatic #2; //Method java/lang/Integer.valueOf:(I)Ljava/lang/Integer;
   5: astore_1
   6: bipush 125
   8: invokestatic #2; //Method java/lang/Integer.valueOf:(I)Ljava/lang/Integer;
   11: astore_2
   12: getstatic #3; //Field java/lang/System.out:Ljava/io/PrintStream;
   15: aload_1
   16: aload_2
   17: if_acmpne 24
   20: iconst_1
   21: goto 25
   24: iconst_0
   25: invokevirtual #4; //Method java/io/PrintStream.println:(Z)V
   28: return

}

Podemos perceber o autoboxing acontecendo com o Integer.valueOf para as duas variaveis "a" e "b".
Se olharmos o código do método valueOf veremos que se os primitivos estiverem dentro de uma faixa (low e high) o objeto será buscado de um cache. Por padrão os valores do low e high são -127 e 128 respectivamente e podemos alterar o valor do high usando o parametro -Djava.lang.Integer.IntegerCache.high.

public static Integer valueOf(int i) {
 assert IntegerCache.high >= 127;
 if (i >= IntegerCache.low && i <= IntegerCache.high)
  return IntegerCache.cache[i + (-IntegerCache.low)];
 return new Integer(i);
}

Se o número estiver dentro da faixa, o objeto será sempre o mesmo, logo, a comparação com "==" será sempre true. Agora se o número estiver fora dessa faixa, o metodo valueOf sempre cria um novo objeto e a comparação com "==" será false.

Então por que no exemplo da classe C o resultado é true?
Neste caso, a comparação não é entre dois objetos e sim entre um objeto e um primitivo, isso só é possível por conta do unboxing. Vamos ver o bytecode:

class C extends java.lang.Object{
C();
  Code:
   0: aload_0
   1: invokespecial #1; //Method java/lang/Object."<init>":()V
   4: return

public static void main(java.lang.String[]);
  Code:
   0: sipush 280
   3: invokestatic #2; //Method java/lang/Integer.valueOf:(I)Ljava/lang/Integer;
   6: astore_1
   7: getstatic #3; //Field java/lang/System.out:Ljava/io/PrintStream;
   10: aload_1
   11: invokevirtual #4; //Method java/lang/Integer.intValue:()I
   14: sipush 280
   17: if_icmpne 24
   20: iconst_1
   21: goto 25
   24: iconst_0
   25: invokevirtual #5; //Method java/io/PrintStream.println:(Z)V
   28: return

}

Vemos o unboxing acontecendo no método intValue(), então nesse caso a comparação passa a ser entre dois primitivos, o que explica o resultado true.

Para não cair nesse tipo de situação, o correto seria fazer a comparação utilizando o método equals.

sábado, 17 de novembro de 2012

Curiosidade sobre variáveis "final" no java.

Para efeitos didáticos, estive criando uma biblioteca de cópia de objetos. A principio era para ser algo simples, mas a medida que fui desenvolvendo foram surgindo problemas que envolveram alguns estudos sobre reflection. Um deles foi em relação a manipulação de atributos "final". Lendo sobre o assunto na especificação do java aprendi um comportamento interessante.

Vejamos o seguinte código:

public class Foo{
    public static final int a = 10;
}


public class Bar{
    public static void main(String[] args){
        System.out.println(Foo.a);
    }
}

Se compilarmos e rodarmos o resultado será 10.
O que vai acontecer se alterarmos o valor da variável i para 30 e compilarmos somente a class Foo?
Se rodarmos a classe Bar veremos que ainda assim o resultado será 10.

Isso acontece por que ao compilarmos nosso código, as *constantes são substituídas pelo seus valores literais, ou seja, no bytecode da classe Bar, não existe referencia pra classe Foo, na verdade, dentro do System.out.println estará escrito o literal 10.

Podemos verificar isso executando o comando javap -c:


class Um extends java.lang.Object{
Um();
  Code:
   0: aload_0
   1: invokespecial #1; //Method java/lang/Object."<init>":()V
   4: return

public static void main(java.lang.String[]);
  Code:
   0: getstatic #2; //Field java/lang/System.out:Ljava/io/PrintStream;
   3: bipush 10
   5: invokevirtual #3; //Method java/io/PrintStream.println:(I)V
   8: return

}


*Várias regras devem ser avaliadas para considerarmos uma variável uma constante, mas resumindo, o seu valor deve ser conhecido em tempo de compilação.

Como no exemplo abaixo:


public class Valor {

 final int compilacao = 1;
 final int execucao;

 public Valor(int execucao) {
  this.execucao = execucao;
 }

 public static void main(String[] args) throws SecurityException, NoSuchFieldException, IllegalArgumentException, IllegalAccessException {
  Valor valor = new Valor(2);

  System.out.println(valor.compilacao);// aqui imprime 1
  System.out.println(valor.execucao);// aqui imprime 2

  Field fieldCompilacao = Valor.class.getDeclaredField("compilacao");
  Field fieldExecucao = Valor.class.getDeclaredField("execucao");

  fieldCompilacao.setAccessible(true);
  fieldExecucao.setAccessible(true);

  fieldCompilacao.set(valor, 10);
  fieldExecucao.set(valor, 20);

  System.out.println(valor.compilacao);// aqui deveria imprimir 10 mas imprime 1
  System.out.println(valor.execucao);// aqui imprime 20

 }
}


Perceba que o valor da variável "compilacao" é conhecido em tempo de compilação, portanto, no bytecode ela será substituída por seu valor literal, já a variável "execucao" só é conhecida em tempo de execução (no momento de criação do objeto).

Com isso em mente percebi o que estava errando na minha biblioteca de cópia de objetos. Existe uma grande diferença entre algo constante e algo imutável. Para efeitos de testes criei algumas classes com atributos final e sem perceber inicializei esses valores "inline", tornando seu valores conhecidos em tempo de compilação, portanto, constantes. Não vejo muito sentido alterar valores de constantes, a final, são constantes!!

Agora devo trabalhar nesse sentido, copia de objetos, sejam eles imutáveis ou não, deixando de lado as constantes.


Quem quiser conhecer a biblioteca, está no link abaixo:

https://github.com/geraldox100/copyobject

Referências:
http://docs.oracle.com/javase/specs/jls/se7/html/jls-13.html#jls-13.4.9
http://www.javaworld.com/javaqa/2003-03/02-qa-0328-constant.html
http://www.coderanch.com/t/454384/java/java/compile-time-constant

terça-feira, 13 de dezembro de 2011

Estrutura de Dados Parte 1 - Pilha

Este será o primeiro de uma série de post's relacionados à estrutura de dados.

Nessa sequência vou explicar o que é cada uma das estruturas, seus respectivos funcionamentos e aplicações através de exemplos práticos em Java.

Neste primeiro post vou falar sobre a estrutura que eu acredito ser a mais simples, a Pilha.

Antes de definirmos tecnicamente, vamos tentar imaginar exemplos de pilhas no dia-a-dia.
Olhando em volta do quarto onde estou escrevendo, vejo uma pilha de caixas e sei que em alguma delas existe uma pilha de livros. De onde estou sentado consigo ver a pia da cozinha, e adivinhem, existe uma pilha de pratos para serem lavados (irei lavá-los assim que terminar esse post :-P ).

Como o exemplo da pilha de pratos já é bem discutido em outras literaturas, vou aproveitar as caixas e tentar diversificar um pouco.

Recentemente me mudei para um local mais próximo do meu trabalho e na hora de encaixotar os meus livros lembrei que lá não teria uma estante para colocá-los. Me dei conta de que os livros permaneceriam encaixotados por muito tempo, então tentei organizá-los conforme a minha necessidade. Sabia que os livros com menor probabilidade de leitura deveriam ficar no fundo, isso porque se eu precisasse de algum deles o acesso seria mais fácil.

Para pegar um dos primeiros livros colocados na caixa, terei que remover cada um dos que estão no topo.

Com isso, já conseguimos extrair algumas características de uma pilha, como por exemplo, os primeiros livros colocados serão os últimos a serem retirados da caixa. Esse conceito é mais conhecido como LIFO (Last In First Out).

Então tecnicamente falando, pilhas são estruturas de dados que servem para guardar vários elementos, onde os últimos elementos armazenados serão os primeiros a sair.

As pilhas possuem algumas operações básicas de manipulação: PUSH e POP.

PUSH: operação para adicionar um novo elemento no topo da pilha.
POP: operação para remover o elemento que está no topo da pilha.

Outras operações adicionar que podem ser úteis:

first: operação que informa qual é o elemento no topo da pilha.
last: operação que infroma qual é o elemento na base da pilha.
isEmpty: operação que informa se a pilha está vazia.
isFull: operação que informa se a pilha está cheia.

Uma implementação simples de Pilha em Java seria:

public class Pilha {

 private int[] elementos;
 private int posicao = -1;

 public Pilha(int tamanho) {
  this.elementos = new int[tamanho];
 }

 public void push(int i) {
  verificaSeAListaEstaCheia();
  elementos[++posicao] = i;
 }

 public int pop() {
  verificaSeAListaEstaVazia();
  return elementos[posicao--];
 }
 
 public final boolean isEmpty() {
  return posicao < 0;
 }
 
 public final boolean isFull() {
  return posicao==elementos.length-1;
 }
 
 public int size() {
  return posicao < 0 ? 0 : posicao+1;
 }

 private void verificaSeAListaEstaVazia() {
  if(isEmpty())
   throw new IllegalStateException("A Pilha esta vazia");
 }
 
 private void verificaSeAListaEstaCheia() {
  if(isFull())
   throw new IllegalStateException("A Pilha esta cheia");
 }

 public static void main(String[] args) {
  Pilha pilha = new Pilha(5);
  int numero = 1;
  while(!pilha.isFull()){
   pilha.push(numero++);
  }
  
  while(!pilha.isEmpty()){
   System.out.println(pilha.pop());
  }
 }

}

Reparem que ao executar o método main dessa classe, a saída na console será 5 4 3 2 1, nessa ordem, justamente por que o 5 foi  o último elemento inserido.

Fugindo um pouco do escopo do post, não foi tão simples chegar ao resultado final da class Pilha, nem à estrutura da classe, nem saber quais seriam os métodos, os nomes e a interação entre eles.
Fiz muitas modificações até chegar nesse resultado, e por várias vezes acabei gerando bugs em trechos de códigos que já estavam funcionando. O que fazer em um momento como esse?! Simples: Testes de Unidade. Não vou entrar em detalhes do que são Testes de Unidade, vou deixar isso para um post mais adiante. Abordei esse assunto apenas para colocar a minha classe de teste:

public class PilhaTest {

 private Pilha pilha;
 
 @Before
 public void before(){
  pilha = new Pilha(5);
 }

 @Test
 public void quandoIniciarUmPilhaDeveTerTamanhoZero() {
  assertEquals(0, pilha.size());
 }

 @Test
 public void quandoAdicionarUmElementoNaListaDeveModificarOTamanho() {
  pilha.push(1);
  assertEquals(1, pilha.size());
 }
 
 @Test
 public void quandoAdicionarDoisElementoNaListaDeveModificarOTamanho() {
  pilha.push(1);
  pilha.push(2);
  assertEquals(2, pilha.size());
 }
 
 @Test
 public void aPilhaDeveRetornarOUltimoElementoParte1() {
  pilha.push(3);
  assertEquals(3, pilha.pop());
 }
 
 @Test
 public void aPilhaDeveRetornarOUltimoElementoParte2() {
  pilha.push(3);
  pilha.push(9);
  assertEquals(9, pilha.pop());
 }
 
 @Test
 public void aPilhaDeveRetornarOUltimoElementoParte3() {
  pilha.push(3);
  pilha.push(9);
  assertEquals(9, pilha.pop());
  pilha.push(10);
  pilha.push(11);
  assertEquals(11, pilha.pop());
  assertEquals(10, pilha.pop());
  assertEquals(3, pilha.pop());
 }
 
 @Test
 public void oPopDeveRemoverOElementoDaLista() {
  pilha.push(3);
  pilha.push(9);
  assertEquals(9, pilha.pop());
  assertEquals(3, pilha.pop());
 }
 
 @Test
 public void oPopDeveAlterarOTamanhoDaLista() {
  assertEquals(0, pilha.size());
  
  pilha.push(3);
  pilha.push(9);
  assertEquals(2, pilha.size());
  
  assertEquals(9, pilha.pop());
  assertEquals(1, pilha.size());
  
  assertEquals(3, pilha.pop());
  assertEquals(0, pilha.size());
 }
 
 @Test
 public void perguntarParaUmaPilhaVaziaSeEleaEstaVazia(){
  assertTrue(pilha.isEmpty());
 }
 
 @Test
 public void perguntarParaUmaPilhaCheiaSeEleaEstaVazia(){
  pilha.push(10);
  assertFalse(pilha.isEmpty());
 }
 
 @Test
 public void perguntarParaUmaPilhaQueJaFoiBemManipuladaSeElaEstaVaziaParte1(){
  pilha.push(10);
  pilha.pop();
  assertTrue(pilha.isEmpty());
 }
 
 @Test
 public void perguntarParaUmaPilhaQueJaFoiBemManipuladaSeElaEstaVaziaParte2(){
  pilha.push(10);
  pilha.pop();
  pilha.push(10);
  pilha.pop();
  assertTrue(pilha.isEmpty());
 }
 
 @Test
 public void perguntarParaUmaPilhaQueJaFoiBemManipuladaSeElaEstaVaziaParte3(){
  pilha.push(10);
  pilha.pop();
  pilha.push(10);
  assertFalse(pilha.isEmpty());
 }
 
 @Test(expected=IllegalStateException.class)
 public void quandoChamarOPopEmUmaPilhaVaziaParte1() {
  pilha.pop();
 }
 
 @Test(expected=IllegalStateException.class)
 public void quandoChamarOPopEmUmaPilhaVaziaParte2() {
  pilha.push(1);
  assertEquals(1, pilha.pop());
  pilha.pop();
  
 }
 
 @Test(expected=IllegalStateException.class)
 public void quandoChamarOPushEmUmaListaQueEstaCheia() {
  pilha.push(1);
  pilha.push(2);
  pilha.push(3);
  pilha.push(4);
  pilha.push(5);
  
  pilha.push(6);
 }
 
 @Test
 public void perguntarParaUmaPilhaCheiaSeEleaEstaCheia(){
  pilha.push(1);
  pilha.push(2);
  pilha.push(3);
  pilha.push(4);
  pilha.push(5);
  assertTrue(pilha.isFull());
 }
 
 @Test
 public void perguntarParaUmaPilhaVaziaSeEleaEstaCheia(){
  assertFalse(pilha.isFull());
 }
 @Test
 public void perguntarParaUmaPilhaSemiVaziaSeEleaEstaCheia(){
  pilha.push(1);
  pilha.push(2);
  assertFalse(pilha.isFull());
 }
 
 @Test
 public void perguntarParaUmaPilhaQueJaFoiBemManipuladaSeElaEstaCheia(){
  pilha.push(1);
  pilha.push(2);
  pilha.push(3);
  pilha.push(4);
  pilha.push(5);
  assertTrue(pilha.isFull());
  pilha.pop();
  assertFalse(pilha.isFull());
 }
}


Pilhas podem ser usadas para várias situações, exemplos clássicos são os de uma linguagem de programação que usa a pilha para guardar a chamada de métodos (veja mais neste post sobre recursividade) ou uma calculadora que faz o empilhamento das operações para depois executá-las na ordem em que foram inseridas.
Aguardem o próximo post sobre Filas.

quarta-feira, 23 de novembro de 2011

Seu código é legível?

Não sei como isso funciona para as outras pessoas, mas sempre que volto para um código que escrevi há algum tempo, tenho dificuldade em lembrar o propósito ou o funcionamento desse código. Pior que isso só quando tenho que mostrar pra alguém e esse alguém percebe que nem eu estou entendendo o que eu escrevi. Isso porque no começo da minha jornada no mundo da programação, dava pouco valor a alguns detalhes que podem fazer uma enorme diferença na hora de ler e entender o código.

Imaginando o cenário de uma locadora, vamos analisar o seguinte trecho de código:

    Cliente cliente = new Cliente();
    cliente.setNome("Geraldo Ferraz");
 
    Filme filme = new Filme();
    filme.setNome("Star Wars");
 
    Locadora locadora = new Locadora();
 
    locadora.getFilmes().add(filme);
    locadora.getClientes().add(cliente);
 
    Locacao locacao = new Locacao();
    locacao.setCliente(cliente);
    locacao.setFilme(filme);
    locacao.setData(Calendar.getInstance());
 
    locadora.getLocacoes().add(locacao);
    locadora.getLocacoes().remove(locacao);

O que esse código faz?
Se você concluiu rapidamente que esse código está cadastrando o cliente "Geraldo" e imediatamente fazendo a locação do filme "Star Wars" é porque provavelmente você está familiarizado com essa  implementação. Pra quem não está e mesmo assim chegou na mesma conclusão, onde sentiu mais dificuldade?

Teria sido mais fácil se o código estivesse assim:

    Cliente geraldo = new Cliente("Geraldo Ferraz");
    Filme starWars = new Filme("Star Wars");

    Locadora locadora = new Locadora();
    locadora.associar(geraldo);
    locadora.adicionarAoAcervo(starWars);
 
    locadora.locarFilme(starWars).para(geraldo);
    geraldo.devolverPara(locadora).oFilme(starWars);

Não importa o nível de experiência que você tenha com programação, o segundo código é mais legível até por quem não é desenvolvedor. Isso porque o segundo código é muito mais expressivo e semântico.

Antes de continuarmos, vamos definir o que é expressividade e semântica.

Semântica:
É o estudo do significado. A semântica linguística estuda o significado usado por seres humanos para se expressarem através da linguagem.

Expressividade:
Claro, significativo, que dá a entender, enérgico.

Então se aplicarmos o conceito de semântica e expressividade nos nossos códigos, teremos códigos que são compreensíveis, claros e sem qualquer tipo de dupla interpretação.
Para conseguirmos um código expressivo e semântico precisamos ser críticos com o que escrevemos e temos sempre que fazer a seguinte pergunta: "será que outros entenderão o que escrevi?".

Ainda dentro do mesmo cenário (locadora), vamos analisar o seguinte código:

 public void executar(Locacao loc) {
     long dif = 0;
     
     if (loc.getDataEntrega().getTimeInMillis() < Calendar.getInstance().getTimeInMillis()) {
      
      long hj = Calendar.getInstance().getTimeInMillis();
      long dtLoc = loc.getDataEntrega().getTimeInMillis();
      dif = (hj-dtLoc)/1000/60/60/24;
      
     }
     loc.setValorPago(loc.getFilme().getCategoria().getPreco() * (dif+1));
     
     filmes.add(loc.getFilme());
 }

O código acima não possui expressividade ou semântica alguma. Podemos notar isso claramente quando demoramos alguns minutos para saber que esse código está fazendo a devolução de um filme para a locadora.

Para tornar esse código mais expressivo e semântico, precisamos ser críticos com pequenos detalhes.

"executar" é algo muito genérico para o nome de um método, precisamos deixá-lo com um significado mais forte, algo que deixe claro qual é a verdadeira intenção do método. Vamos experimentar "efetuarDevolucao".

Muitos desenvolvedores estão acostumado a abreviar os nomes das variáveis. Nunca entendi essa prática, pensava que fosse por hábito ou alguma convenção, mas logo percebi que era por pura preguiça. Com todo o poder que as IDEs têm hoje em dia (auto-complete), não justifica abreviar os nomes das variáveis. Algumas pessoas podem até defender a Notação Húngara, mas eu acredito que se o nome for expressivo o suficiente chegaremos à mesma conclusão que a Notação Húngara propõe.
Vamos mudar "loc" para "locacao", "dif" para "diferencaDeDias", "dtLoc" para "dataLocacao" e "hj" para "hoje".

Vejamos como ficou nosso código depois dessas pequenas modificações:

public void efetuarDevolucao(Locacao locacao) {
     long diferencaDeDias = 0;
     
     if (locacao.getDataEntrega().getTimeInMillis() < Calendar.getInstance().getTimeInMillis()) {
      
      long hoje = Calendar.getInstance().getTimeInMillis();
      long dataLocacao = locacao.getDataEntrega().getTimeInMillis();
      diferencaDeDias = (hoje-dataLocacao)/1000/60/60/24;
      
     }
     locacao.setValorPago(locacao.getFilme().getCategoria().getPreco() * (diferencaDeDias+1));
     
     filmes.add(locacao.getFilme());
 }

Bem melhor, mas ainda está longe do ideal. Vamos analisar o primeiro "if", que pega a data da entrega e verifica se a mesma é menor que a data de hoje. O que, em muitas palavras, está perguntando se a devolução está atrasada. Essa pergunta está relacionada diretamente ao estado da locação, então devemos fazer essa pergunta diretamente pra a locação. Vejamos o resultado:

public void efetuarDevolucao(Locacao locacao) {
     long diferencaDeDias = 0;
     
     if (locacao.estaAtrasada()) {
      
      long hoje = Calendar.getInstance().getTimeInMillis();
      long dataLocacao = locacao.getDataEntrega().getTimeInMillis();
      diferencaDeDias = (hoje-dataLocacao)/1000/60/60/24;
      
     }
     locacao.setValorPago(locacao.getFilme().getCategoria().getPreco() * (diferencaDeDias+1));
     
     filmes.add(locacao.getFilme());
 }

Repare que até aqui não houve mudança na estrutura, apenas modificações simples nos nomes dos métodos e variáveis e mesmo assim já conseguimos ter uma leitura muito melhor do código.

Robert C. Martin, autor do livro Agile Software Development, Principles, Patterns, and Practices e Clean Code (um dos melhores livros que já li), fala sobre um princípio muito importante: Single responsability principle. O princípio explica que um módulo deve ter uma única responsabilidade, e no livro ele descreve a "responsabilidade" como "um motivo para mudar", e cita o exemplo de um gerador de relatório. Esse gerador tem dois  motivos para mudar, primeiro, o conteúdo exibido, segundo, o layout. Esses dois motivos bem definidos são considerados motivos diferentes, portanto responsabilidades diferentes.
Com base nesse conceito, podemos perceber que o método "efetuarDevolucao" está com mais responsabilidades do que uma simples devolução. Para resolver isso temos que entender qual é o fluxo da devolução:
  1. Efetuar o pagamento
  2. Devolver o filme para o acervo.
Então devemos isolar a regra do pagamento na própria classe Locacao, resultando no seguinte código:

public void efetuarDevolucao(Locacao locacao) {
 locacao.efetuarPagamento();
 devolverFilmeParaOAcervo(locacao.getFilme());
}

private void devolverFilmeParaOAcervo(Filme filme) {
 filmes.add(filme);
}

Resolvemos a primeira parte, agora vamos ver como ficou a classe locação.

public void efetuarPagamento(){
  long diferencaDeDias = 0;
      
      if (dataEntrega.getTimeInMillis() < Calendar.getInstance().getTimeInMillis()) {
       
       long hoje = Calendar.getInstance().getTimeInMillis();
       long dataLocacao = dataEntrega.getTimeInMillis();
       diferencaDeDias = (hoje-dataLocacao)/1000/60/60/24;
       
      }
      valorPago = filme.getCategoria().getPreco() * (diferencaDeDias+1);
 }

Bem, parece que apenas empurramos o problema pra dentro da classe Locacao. Ainda não está claro como o método efetuarPagamento funciona. Para melhorar esse código devemos seguir os mesmos passos anteriores. Veja que as variáveis já possuem nomes significativos, então vamos definir quais são os passos para efetuar o pagamento e identificarmos se o método está com mais responsabilidade do que deveria.
  1. Verificar se já está pago.
  2. Verificar se está atrasado.
  3. Se estiver atrasado, cobrar multa.
  4. Se não estiver atrasado, fazer cobrança normal.
Com um pouco de trabalho, chegamos ao seguinte resultado:

public class Locacao {
 
 private DateUtil util = new  DateUtil();
 
 public void efetuarPagamento() {
  if(!estaPago()){
   if (estaAtrasada()) {
    efetuarPagametnoAtrasado();
   }else{
    efetuarPagamentoPontual();
   }
  }
 }
 
 private boolean estaPago(){
  return valorPago > 0;
 }
 
 private boolean estaAtrasada() {
  return util.ehDepoisDeHoje(dataEntrega);
 }

 private void efetuarPagametnoAtrasado() {
  valorPago = filme.getCategoria().getPreco() * quantidadeDeDiasAtrasados();
 }
 
 private void efetuarPagamentoPontual() {
  valorPago = filme.getCategoria().getPreco();
 }

 private long quantidadeDeDiasAtrasados() {
  return util.diasEntre(dataEntrega, DateUtil.HOJE);
 }
}
Agora conseguimos entender facilmente o que o "efetuarPagamento" está fazendo. Para uma leitura rápida, não temos a necessidade de olhar o conteúdo de cada método, faremos isso apenas se realmente houver a necessidade de modificarmos algum deles especificamente.

O blog VidaGeek.net recentemente fez um post falando sobre expressividade e nele o autor tenta mostrar a importância da expressividade em contextos do mundo real, como o de um escritor.
O autor fala também que um escritor tem à sua disposição vários recursos dentro de sua ferramenta que é a linguagem. Cabe a cada escritor escolher qual recurso é mais recomendado no momento ou para o público alvo.

Discutir semântica não é uma tarefa fácil, talvez por ser algo subjetivo, o que é mais significativo pra mim talvez não seja para outra pessoa. Em termos técnicos, acredito que a melhor opção é tentar ser o mais simples e breve possível e lembrar sempre que um código legível não facilita a manutenção apenas para os outros, mas pra si mesmo também.


Referências:
Semantica
Separation of concern
Single Responsability
Cohesion

segunda-feira, 21 de novembro de 2011

Recursividade

O assunto deste post será Recursividade e para prender a sua a atenção vou começar com uma piada clássica (dedicado a @lacerdaph):

Para entender a recursividade, antes, você tem que entender a recursividade.


 Agora vamos a parte técnica. Primeiro vou tentar definir de maneira simples, o que é recursividade:

Recursividade é a capacidade que uma função/método tem de invocar a si mesmo. 

Em outras palavras a recursividade é a maneira de dividir um problema em vários subproblemas sem adicionar nova complexidade.

Com isso em mente temos o seguinte exemplo:

public static void main(String[] args) {
 diminui(10);
}

private static void diminui(int i) {
 System.out.println(i);
 if (i > 0)
 diminui(i - 1);
}
O método "diminui" serve para imprimir uma sequencia de números de maneira decrescente até o número zero. Note que para isso não existe nenhuma estrutura de loop como "while" ou "for", apenas uma chamada a ele mesmo com um argumento menor que o inicial. Podemos dizer que o método diminui é recursivo por que ele faz uma chamado a si mesmo se o número ainda for maior que zero.

Podemos aplicar a recursividade em exemplos mais complexos como exibir uma estrutura de pastas e arquivos. Em java ficaria assim:

public static void main(String[] args) {
 listaConteudo(new File("/home/geraldo"));
}

private static void listaConteudo(File arquivo) {
 if (arquivo.isDirectory()) {

  System.out.println("Diretorio " + arquivo.getName());

  File[] subArquivos = arquivo.listFiles();
  for (File subArquivo : subArquivos) {
   listaConteudo(subArquivo);
  }

  } else {
   System.out.println(" Arquivo " + arquivo.getName());
  }
 }
}


Ou em exemplos mais didáticos como a sequência de Fibonacci:

public static void main(String[] args) {
 System.out.println(fibonacci(10));
}

public static int fibonacci(int n) {
 return n == 1 || n == 0 ? 1 : fibonacci(n - 1) + fibonacci(n - 2);
}

Algo pra se ter em mente é que todo algoritmo recursivo pode ser feito também de maneira interativa. Em termos de performance é quase sempre mais vantajoso usar o algoritmo interativo, isso porque as linguagens que permitem execuções recursivas trabalham usando uma pilha de chamada ou um stack de execução.

Podemos entender a pilha como sendo o local onde a linguagem guarda o estado de cada método sendo executado. O último método na pilha é o que está sendo executado no momento como mostra a imagem a seguir:

Com isso podemos verificar que a maior limitação de uma chamada de método recursivo é o tamanho da pilha. Isso quer dizer que  se chegarmos a capacidade máxima da pilha não conseguiremos fazer chamada de nenhum outro método provocando um estouro na pilha (StackOverflow).

Existem alguns tipos de chamada recursiva e a escolha da mesma pode melhorar/otimizar o uso da pilha permitindo mais empilhamento de métodoos.

Recursividade simples: é quando fazemos apenas uma chamada recursiva por vez. Ex: o método diminui.
Recursividade dupla: é quando fazemos 2 ou mais chamadas recursivas por vez. Ex: o método fibonacci.
Recursividade em Cauda: é quando a chamada recursiva é a última instrução executada.

Vou focar nesta última pois acho que é a que traz o ganho mais significativo.
Para se trabalhar com a recursão em cauda, não basta ser a última linha de código, tem que ser a ultima instrução a ser executada pelo processador. No exemplo abaixo vamos calcular o fatorial de um número, parece que estamos usando recursão em cauda, mas note que a ultima instrução executada será a multiplicação de "n" e o retorno da chamada recursiva:

public static long fatorial(long n) {
 if (n == 0) return 1;
  return n * fatorial(n - 1);
 }
}

Isso faz com que a linguagem tenha que manter o método na pilha pra poder executar a multiplicação. No exemplo abaixo, visto que não tem mais nada pra fazer quando voltar da chamada recursiva, não é necessário manter esse método na pilha, então a linguagem pode remove-lo abrindo espaço para outra chamada.

public static long fatorial(long n, long acumulador) {
 if (n == 0) 
  return acumulador;
 return fatorial(n - 1, n * acumulador);
}

public static long factorial(long n) {
 return fatorial(n, 1);
}

Uma outra forma de ganhar performance e otimizar o uso da pilha é aplicar uma técnica chamada Memoization que consiste em guardar algum valor previamente calculado evitando assim um novo empilhamento e evitando o custo de processamento. Veja no exemplo abaixo novamente o cálculo da sequencia de Fibonacci:

private static Map<Long, Long> jaCalculados = new HashMap<Long, Long>();

public static long fibonacciMemoization(long n) {
 if (jaCalculados.containsKey(n))
  return jaCalculados.get(n);

 Long valorCalculado;
 if (n == 0 || n == 1)
  valorCalculado = n;
 else
  valorCalculado = fibonacciMemoization( n - 1 )+ fibonacciMemoization(n - 2);

 jaCalculados.put(new Long(n), valorCalculado);
 
 return valorCalculado;

}

Após muita conversa com amigos (@moreira_caelum e @renatoargh)  cheguei a conclusão de que gosto de recursividade quando a implementação torna o código mais expressivo e legível sem impactar significativamente no desempenho. A partir do momento em que a recursividade prejudica o entendimento ou a performance do algoritmo, prefiro o modelo iterativo.


Referências:
Recursividade (Wikipedia)
Recursividade Simples, Dupla e em Cauda
Recursividade em cauda
Memoization (Wikipedia)
Dica de leitura Analise de Algoritmo